预制服务
共绩算力 Laya 镜像使用说明
Laya 是什么
Laya 是 ConvAI Innovations 开源的轻量级决策模型。它接收文本或 JSON 状态,以及开发者定义的问题和候选答案,返回分类结果、评分与概率,适合工单分流、邮件分类和条件判断。
本教程部署的是英文 Laya 检查点的 GGUF 版本,采用 ModernBERT-large 编码器与决策头,约 4.21 亿参数,默认上下文为 512 token,权重采用 Apache 2.0 许可。平台通过 llama.cpp 加载 Laya-BF16.gguf,提供 POST /v1/systemone 接口。
它适合候选答案能够提前定义的任务。开发者给出问题和选项,模型根据输入评分,业务程序读取结果后执行分流或设置处理优先级。
Laya 与其他语言模型有什么区别?
常见的生成式语言模型通过逐个生成 token 来回答问题,可以用于聊天、问答、写作和代码生成,也可以按照提示词或格式约束输出 JSON。Laya 则面向决策任务:开发者提前定义问题和候选答案,模型直接对候选项评分,返回结构化结果与概率。
以客服工单为例,使用生成式语言模型,可以要求它判断负责团队并解释原因;使用 Laya,则提交“技术、账务、其他”三个选项,读取各自的概率,再由程序执行分流。前者适合需要生成内容或解释的场景,后者适合答案范围明确、需要由程序读取评分并采取行动的场景。
| 对比项 | 常见生成式语言模型 | Laya |
|---|---|---|
| 回答方式 | 逐个生成 token | 对预设问题的候选项评分 |
| 输出结果 | 文本,或按指定格式生成 JSON | 所选项、评分与概率 |
| 内容生成 | 支持写作、问答等内容生成 | 不生成自由文本 |
| 解释理由 | 可以生成解释文本 | 不生成自由文本解释 |
| 答案范围 | 可以开放,也可以通过提示词或约束限制 | 在请求中定义候选项、评分等级或判断条件 |
| 适用任务 | 聊天、写作、问答、代码生成 | 分类、路由、评分、条件判断 |
| 程序接入 | 读取生成文本或结构化输出 | 读取 answers 中的选项与概率 |
本镜像加载的是英文检查点。下面使用英文工单验证;中文或其他语言任务需要另行选择相应检查点,不能将此单模型服务视为自动多语言路由服务。
Laya 的输出:选项、评分与概率
Laya 返回结构化决策结果。每个问题的答案位于响应的 answers 中,以请求时定义的问题 ID 对应。不同问题类型,返回形式也不同。llama.cpp SystemOne 接口说明
| 问题类型 | 用途 | 主要返回字段 |
|---|---|---|
| choice | 从预设选项中选择 | choice、probabilities、confidence |
| score | 按有序等级评分 | score、legend、probabilities、confidence |
| noul | 判断指定条件是否成立 | noul,表示该条件为真的概率 |
score 返回按概率加权的等级索引,可以是小数。例如三个等级的索引为 0、1、2,结果可能位于两个等级之间。noul 返回 0 到 1 的数值,需要由程序根据业务规则决定如何处理。
部署流程
01. 进入弹性部署服务并新增任务
访问 弹性部署服务页面,在左侧找到“新增部署任务”。
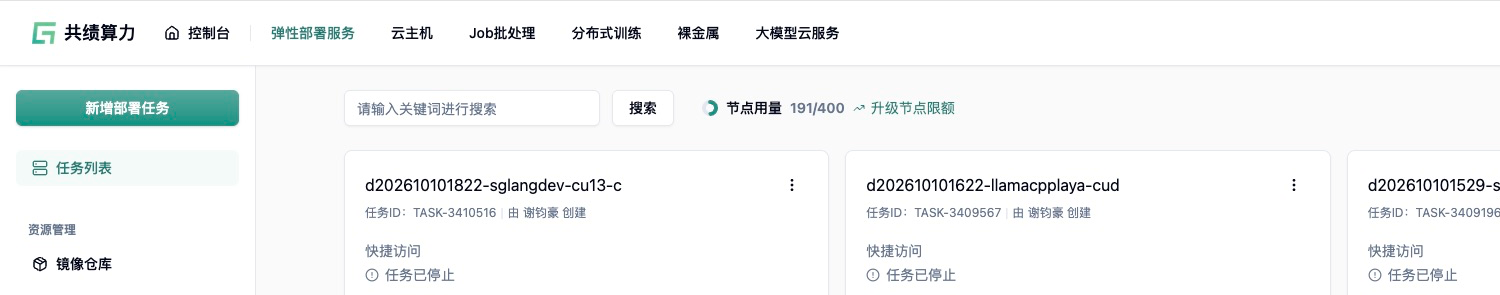
点击“新增部署任务”,进入 任务创建页面。若页面跳转到登录,先完成账号登录。
02. 选择计算资源
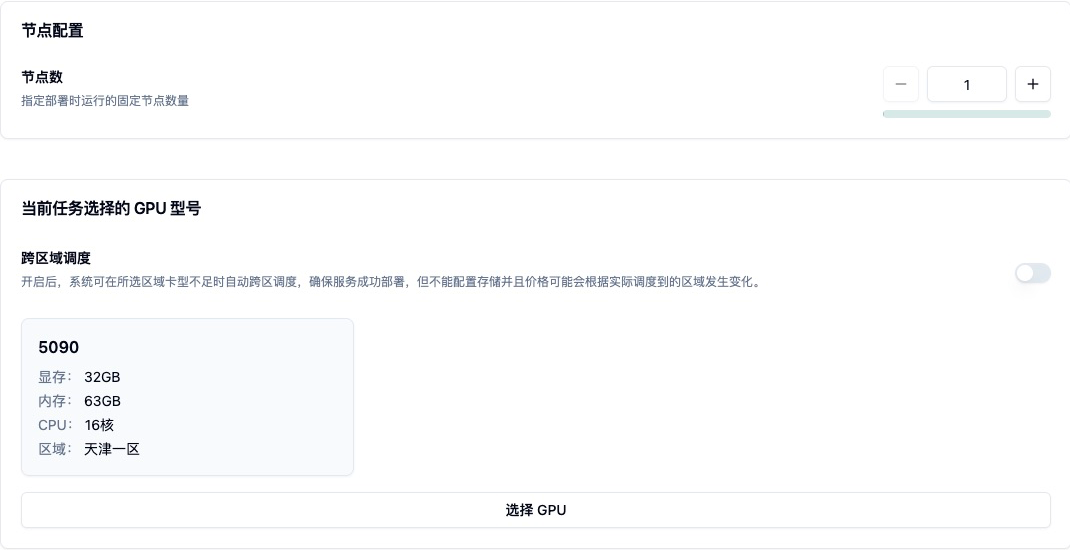
在计算资源区域选择 RTX 5090,卡数从 1 卡开始;RTX 4090 可作为备选。核对可用资源、CPU、内存和价格后,继续下拉至服务配置。
下面是现有 Laya 任务的配置:天津一区、单卡 RTX 5090、32GB 显存、63GB 内存、16 核 CPU、1 个节点。5090 节点的归档日志记录了模型加载成功;4090 未在本次任务中实测。
03. 选择 Laya 预制服务
在“服务配置”中查找并选择 Laya,使用平台对应的预制镜像与默认配置。
本教程使用以下镜像:
harbor.suanleme.cn/public-hub/llama.cpp:laya-cuda12-20261009容器通过 llama-server 加载下面的模型文件:
/models/ggml-org/Laya-GGUF/Laya-BF16.gguf这是 llama.cpp 单模型服务。调用时使用 /v1/systemone,由已经加载的 Laya 模型回答问题。
04. 等待实例就绪
返回任务列表或详情,观察实例状态与启动日志。首次启动可能涉及镜像拉取、权重加载和服务初始化。
该任务的 RTX 5090 节点归档日志包含以下记录:
srv          init: decision model type: laya
srv  llama_server: model loaded
srv  llama_server: listening on http://0.0.0.0:8080
看到 model loaded 和 listening on http://0.0.0.0:8080,说明模型加载完成,HTTP 服务开始监听。随后还需通过接口请求验证服务是否可以正常返回答案。
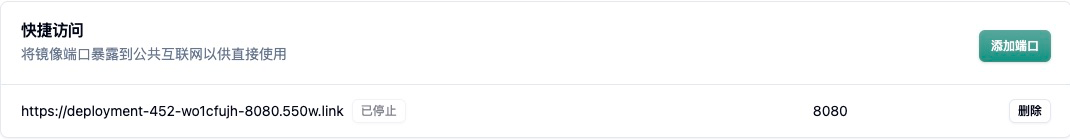
在“快捷访问”中复制 8080 端口对应的对外服务地址。本任务页面中记录的地址为:
https://deployment-452-wo1cfujh-8080.550w.link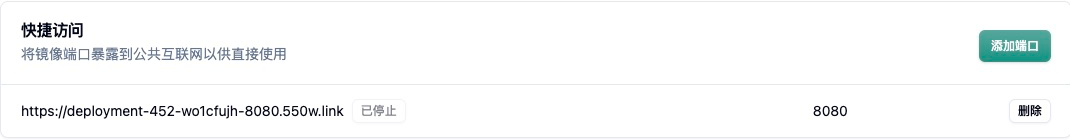
该任务在读取时处于“已停止”状态。使用下面的地址前,需要先恢复任务运行;若重新部署导致域名变化,以任务详情中的最新地址为准。
小例子:工单自动分流
假设客服系统收到一条工单:
The application crashes every time I open settings. Please help today.
每次打开设置时,应用都会崩溃。请今天帮我解决。
我们希望一次请求完成两个判断:
- 负责团队:从技术、账务和其他三个选项中选择。
- 是否请求今天得到帮助:返回这一判断为真的概率。
使用 cURL 调用
下面的服务地址已经替换为该任务的 URL。任务运行并就绪后,可以使用以下请求,并将响应保存为 laya-response.json:
export SERVICE_URL="<服务的url>"

curl --fail-with-body --max-time 120 \
  "${SERVICE_URL%/}/v1/systemone" \
  -H "Content-Type: application/json" \
  --data-binary @- <<'JSON' | tee laya-response.json
{
  "state": "The application crashes every time I open settings. Please help today.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "technical": "Application bugs or outages",
        "billing": "Payments, invoices or refunds",
        "other": "Other requests"
      }
    },
    "urgent": {
      "type": "noul",
      "instructions": "Does the user request help today?"
    }
  }
}
JSON其中,state 是待判断的工单内容,questions 定义需要回答的问题。department 和 urgent 是自行定义的问题 ID,响应会通过相同 ID 返回答案。
choice 用于在候选项中选择,criteria 描述各选项的含义;noul 用于返回指定判断为真的概率。本例省略 model,使用服务已加载的单个模型。
历史启动日志显示服务当时未设置 API Key。若后续开启鉴权,需要设置真实密钥,并在请求中增加:
-H "Authorization: Bearer ${SERVICE_API_KEY}"实际响应
当前任务已停止,本次尚未取得该工单的真实响应,因此此处不填写概率数值。任务恢复后,运行上面的请求,laya-response.json 即为实际响应,可直接将其中的完整 JSON 放入本节。
响应应包含 answers.department 与 answers.urgent,并通过请求中的问题 ID 对应答案;具体选择结果和概率以实际接口返回为准。
输出说明
| 字段 | 含义 | 程序中的读取方式 |
|---|---|---|
| department.choice | 模型选择的负责团队 | answers[“department”][“choice”] |
| department.probabilities | 各团队的概率 | 按 technical、billing、other 读取 |
| department.confidence | 分类结果的置信度指标 | answers[“department”][“confidence”] |
| urgent.noul | 用户请求今天得到帮助的概率 | answers[“urgent”][“noul”] |
这条工单描述了应用崩溃,我们希望模型能据此识别技术类问题;“Please help today” 则对应第二个问题。是否正确识别,需要核对真实响应,不能仅凭输入内容预填模型结果。
这里的 urgent 只是问题名称,实际判断的是“用户是否请求今天得到帮助”。若要判断故障等级、业务影响或是否需要立即升级处理,应另行定义对应问题。
confidence 与所选项的 probabilities 是不同字段,不能把两者混用。概率也不等同于分类准确率。
在程序中使用结果
获得响应后,可以读取所选团队和概率,并设置业务规则:
import json

# 读取上面的 cURL 请求保存的实际响应。with open("laya-response.json", encoding="utf-8") as file:
    result = json.load(file)

answers = result["answers"]

department = answers["department"]["choice"]
department_probability = answers["department"]["probabilities"][department]
help_today_probability = answers["urgent"]["noul"]

print(f"负责团队:{department}")
print(f"所选团队概率:{department_probability:.2%}")
print(f"请求今天得到帮助的概率:{help_today_probability:.2%}")

# 示例规则:概率达到 80% 时标记为优先处理。# 该阈值由业务程序设置,应结合实际数据确定。
priority = "优先处理" if help_today_probability >= 0.8 else "常规处理"print(f"按示例规则设置优先级:{priority}")
程序会打印实际返回的团队、所选团队概率,以及按示例规则计算出的优先级。模型负责评分,程序依据结果分配工单;上线前应使用自己的代表性工单验证效果并确定阈值。