常见问题
云主机常见问题
云主机常见问题:计费、关机方式、共享存储卷、启动命令、SSH 密码、Docker 限制与数据存放建议。
平台使用
如何计费
如何计费
按量(使用时长)计费,精确到秒。镜像上传拉取过程不收费,开机过程不收费,关机过程不收费,服务成功部署后再计费 卡时单价、机型详见:https://www.gongjiyun.com/pricing.html 更详细的计费规则:云主机计费说明
什么是云主机?
什么是云主机?
共绩算力云主机是一款面向 AI 开发的云端工作站,支持随时随地远程访问。它提供完整的开发环境与高性能算力资源,按需计费,让您专注于高效创新,无需操心硬件采购与环境配置。
**请注意:**云主机采用容器化运行环境,而非传统虚拟机,因此不支持在主机内部再启动 Docker 服务。直接写入系统盘路径的文件会被纳入整体镜像环境,进而影响关机时长,建议将持久化数据存放于指定数据卷或外部存储中。
- 平台不支持 windows 系统,
- 平台不直接连接外网,无法直接使用外网的镜像仓库比如docker.io等,如果需要下载模型等可以使用国内的模型源
云主机的主要功能特点
- 集成开发环境:在平台预制的基础镜像中提供完整开发工具链,支持主流 AI 框架(如 PyTorch、TensorFlow 全家桶),免去环境配置烦恼,让您专注于开发本身。
- 镜像管理系统:高效管理镜像版本,支持一键发布和分发,极大提升开发与部署效率。
- 一键 Serverless 发布:开发完成后可一键发布为 Serverless 服务,快速为用户提供在线服务。
- 分布式训练支持:支持 1 机多卡和多机联网,轻松实现模型微调和大规模模型训练。
关机、关机并保存镜像、强制关机的区别是什么?
关机、关机并保存镜像、强制关机的区别是什么?
云主机提供三种不同的关机方式,分别适用于不同的使用场景。以下详细说明各种方式的特点和使用注意事项。
1. 普通关机
功能说明:
普通关机会安全地关闭云主机并停止计费,类似于正常关闭电脑。所有数据和已安装的软件都会完整保存,下次开机时可以完全恢复到关机前的状态。
主要特点:
- 立即停止计费,节省成本
- 数据完整保存,包括系统盘和数据盘
- 已安装的软件和配置不会丢失
- 支持随时重新开机
注意事项:
- 关机后会释放所有计算节点资源
- 重启时显卡库存可能无法保障(如使用 GPU 实例)
- 请在业务允许的情况下谨慎操作
适用场景: 临时不使用实例,希望停止计费但保留完整环境
2. 关机并保存镜像
功能说明:
在关机的同时,将当前实例的完整状态保存为自定义镜像。这个镜像可以作为”黄金副本”,用于快速创建多个相同配置的新实例,实现环境的快速复制和部署。
主要特点:
- 创建可复用的自定义镜像
- 保存完整的系统环境和配置
- 支持基于镜像快速创建新实例
- 关机期间不产生费用
操作流程:
- 实例自动执行关机操作
- 系统创建自定义镜像(需要一定时间)
- 保存完成后实例保持关机状态
- 镜像可在创建新实例时选择使用
数据安全保障:
- 所有数据完整保存在镜像中
- 原实例数据不会丢失
- 可基于镜像创建多个副本
适用场景: 需要备份当前环境配置,或批量部署相同环境的实例
3. 强制关机
功能说明:
强制关机会立即终止实例运行,不进行正常的关机流程。这是一个紧急操作选项,会导致本次开机后的所有实例内变更丢失,状态回滚到本次开机之前。
重要特性:
- 立即强制终止实例
- 实例内状态回滚到本次开机前
- 共享存储卷数据不受影响
- 操作不可撤销
数据影响:
- 实例内未保存的数据将丢失
- 本次开机后的系统变更将丢失
- 共享存储卷中的数据保持完整
严重警告:
此操作类似于直接拔掉电源,可能导致数据丢失或系统损坏。除非实例无响应或遇到紧急情况,否则不建议使用此方式。操作不可撤销,请务必谨慎评估!
适用场景: 实例卡死、无响应等紧急情况,且确认可以接受数据回滚
对比总结
| 对比项 | 普通关机 | 关机并保存镜像 | 强制关机 |
| 关机方式 | 安全关机 | 安全关机 + 创建镜像 | 强制终止 |
| 计费状态 | 停止计费 | 停止计费 | 停止计费 |
| 数据保存 | 完整保存 | 完整保存(含镜像) | 回滚到开机前 |
| 已装软件 | 保留 | 保留(含镜像) | 回滚到开机前 |
| 重启保障 | 库存可能不足 | 库存可能不足 | 库存可能不足 |
| 额外功能 | 无 | 生成可复用镜像 | 无 |
| 操作风险 | 低 | 低 | 高(数据可能丢失) |
| 可撤销性 | 可重启恢复 | 可重启恢复 | 不可撤销 |
| 共享存储卷 | 不影响 | 不影响 | 不影响 |
| 适用场景 | 临时停用 | 环境备份/批量部署 | 紧急处理 |
选择建议:
- 日常停用实例 → 选择”普通关机”
- 需要备份或复制环境 → 选择”关机并保存镜像”
- 实例卡死无响应 → 最后考虑”强制关机”
什么是 共享存储卷?
什么是 共享存储卷?
共享存储卷是一种可以被多台云主机或 serverless 服务同时挂载和访问的存储资源。它类似于一个网络硬盘,支持跨实例读写数据,适合团队协作、数据共享、模型/数据集分发等场景。
典型用途:
- 多个服务/主机间共享数据、日志、模型文件等。
- 作为持久化存储,服务重启、迁移后数据不丢失。
- 支持大文件、批量数据的高效读写。
挂载方式:
- 在云主机或 serverless 服务创建/设置页面,选择需要挂载的共享存储卷(Bucket),并指定挂载路径(如
/mnt/data)。 - 启动后,系统会自动将存储卷挂载到指定路径,应用可直接读写。
挂载要求:
- 挂载路径必须以
/开头,允许英文、数字、-和/,如/mnt/data。 - 不同存储卷的挂载路径不能重复,避免冲突。
- 路径建议简洁明了,便于程序访问。
共享存储卷和对象存储加速挂载有什么不一样?
共享存储卷和对象存储加速挂载有什么不一样?
功能定位不同:
- 共享存储卷:主要用于高性能、高并发的读写场景。它像传统的硬盘或网络文件系统(如 NFS),可以被多个计算节点同时挂载,支持文件的频繁读写和修改,适合训练数据、模型中间结果、日志等需要频繁读写的场景。
- 对象存储加速挂载:主要用于高效读取大规模数据,通常是只读场景。它将对象存储(如 S3)的数据通过挂载的方式直接呈现为本地文件系统,方便访问和读取,但写入性能和一致性不如共享存储卷,适合加载大数据集、预训练模型等只读需求。
技术实现和性能侧重:
- 共享存储卷:底层通常基于分布式文件系统(如 CephFS、GlusterFS 等),强调高 IOPS 和低延迟,适合高频读写。
- 对象存储加速挂载:底层基于对象存储(如 S3),通过 FUSE 等方式挂载,强调大吞吐量的读取,写入操作一般不推荐或有延迟。
典型应用场景:
- 共享存储卷:团队协作开发、分布式训练、实验结果共享、日志收集等需要多节点读写的场景。
- 对象存储加速挂载:大规模数据集加载、模型权重分发、只读数据分析等。
S3 技术的应用差异:
虽然两者都用到了 S3 技术,但
- 共享存储卷更像是将 S3 作为后端存储,前端通过分布式文件系统实现高性能读写;
- 对象存储加速挂载则是直接将 S3 对象以文件系统方式只读挂载,主要优化读取体验。
云主机的自定义启动命令有什么不一样?
云主机的自定义启动命令有什么不一样?
自定义启动命令,指的是用户可以为云主机或 serverless 服务指定专属的 shell 命令,完全覆盖平台的默认启动逻辑。这一机制赋予了用户极高的灵活性和控制力。
云主机通过与 Supervisord 的深度结合,实现了真正意义上的自定义启动命令。用户不仅可以完全替换平台默认逻辑,指定任意 Shell 命令作为主进程,还能灵活适配多语言、多进程、复杂初始化等多样化业务场景。例如:
- 启动自定义开发的 Python、Node.js、Java 等各类应用
- 执行复杂的初始化脚本(如 bash init.sh),实现环境预配置与自动化部署
- 启动多进程任务、守护进程或特殊服务,满足个性化业务需求
通过 supervisord 的支持,平台不仅能够实时监控主进程的运行状态,还能实现日志收集、异常处理等高级运维功能。用户填写的自定义启动命令会被 supervisord 作为“受管进程”启动和管理,即使主进程异常退出,Supervisord 也能自动拉起,极大提升了服务的高可用性与稳定性。用户只需在服务或主机的创建/设置页面填写自定义启动命令(如 python app.py、bash run.sh),系统将在实例启动时,严格按照用户指定的命令拉起主进程,充分释放业务创新空间,助力多样化场景的高效落地。
如何将云主机一键发布为 Serverless 服务?
如何将云主机一键发布为 Serverless 服务?
- 在云主机实例列表(侧边栏「云主机列表」),选择你要发布的云主机。
- 点击「发布服务」按钮,进入 serverless 服务创建流程。
- 按页面提示填写端口、环境变量、启动命令等信息,确认无误后提交即可一键发布。
- 服务发布后,可在
弹性部署服务管理页面查看、管理和访问你的服务。
可以参考这篇文档来操作:将云主机发布为弹性部署服务
发布 serverless 服务后如何管理和访问?
发布 serverless 服务后如何管理和访问?
- 发布成功后,可点击页面顶部
弹性部署服务按钮,在打开的页面查看和管理发布的服务。 - 支持启动、停止、重启、删除等操作。
- 服务会分配公网访问地址,页面会显示访问方式。
如何修改基础镜像中 SSH、VS Code Server 和 Jupyter Lab 的密码?
如何修改基础镜像中 SSH、VS Code Server 和 Jupyter Lab 的密码?
基础镜像中的 ssh 默认密码在环境变量中,VS Code Server 和 Jupyter Lab 默认没有密码,如果需要密码保护,可以通过以下方法实现:
- 访问:https://console.suanli.cn/server/instances
- 找到要修改的云主机,点击【更多操作】 -> 【查看详情】,在页面顶部点击【环境变量】
- 输入以下变量值
- 【保存】,然后【应用修改】,一定要点击【应用修改】才会生效
为什么云主机内不支持使用 Docker?
为什么云主机内不支持使用 Docker?
共绩算力的云主机本质上是基于容器技术(Docker/Kubernetes)虚拟化出来的实例,而非传统的物理裸金属服务器或 KVM 虚拟机。
由于您当前已经处于一个容器环境中,在容器内部再次运行 Docker Daemon(即 Docker-in-Docker,DinD)会面临严重的安全隔离问题和文件系统挂载冲突。因此,平台在系统层面禁用了云主机内部的 Docker 服务。
最佳实践建议: - 直接配置环境:云主机已经为您提供了一个完整的 Ubuntu 操作系统环境(包含 root 权限),您可以直接使用apt-get、pip、conda 等工具安装所需的软件和依赖,就像在普通 Linux
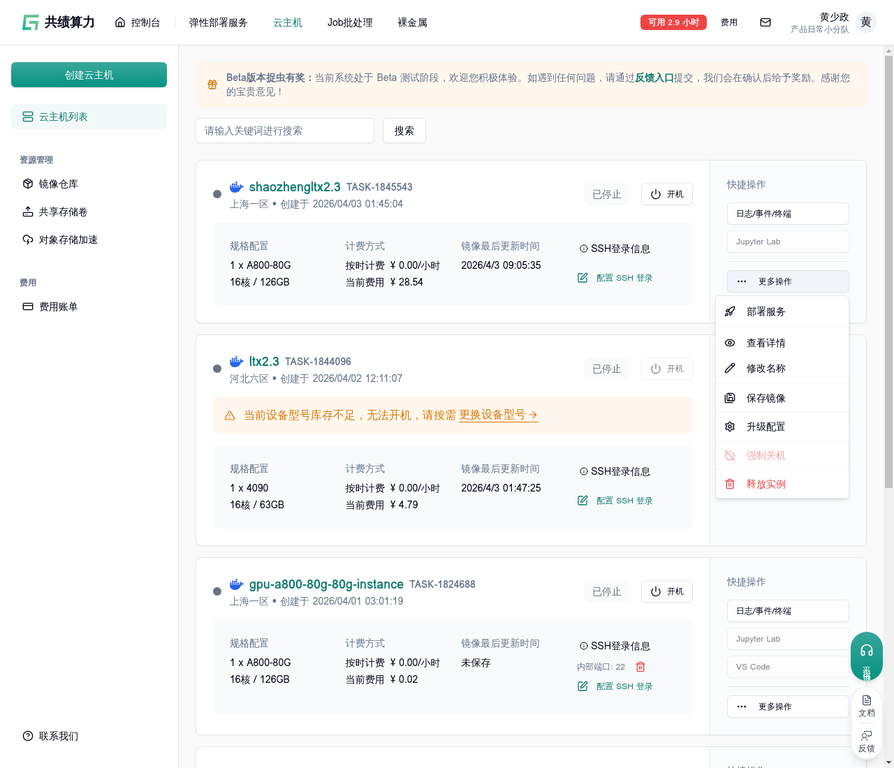
系统中一样。 -保存自定义镜像:配置好专属环境后,您可以在云主机列表页点击”更多操作”->“保存镜像”,将其保存为您的”我的镜像”。下次创建新主机时,直接选择该镜像即可复用环境,完全替代了 Docker 的打包功能。
为什么系统盘写入大量文件会导致开关机变慢?
为什么系统盘写入大量文件会导致开关机变慢?
云主机的系统盘(通常为 80GB)是基于分布式块存储或容器写时复制(CoW)文件系统实现的。当您在系统盘中写入大量数据(如数十 GB 的数据集或模型权重)时:
- 关机保存慢:关机会触发系统盘快照或数据同步机制,写入的数据越多,同步耗时越长。
- 开机恢复慢:开机时需要从底层存储重新拉取或挂载这些数据,数据量直接决定了开机启动时间。
最佳实践建议:
系统盘只用于存放环境和代码:强烈建议将系统盘(/目录)仅用于安装软件环境(如 pip 包)和存放体积较小的代码文件。
数据和模型分离存储:大体积的数据集、模型权重、生成的日志和 Checkpoint 等,必须存放在外挂存储中(如共享存储卷或对象存储加速)。
如何高效管理模型和数据集?
如何高效管理模型和数据集?
为了解决大文件读写和跨实例共享的问题,平台提供了两种专业存储方案。强烈推荐”计算与存储分离”的架构设计。
方案 A:共享存储卷(适合读写频繁的数据集和代码)
共享存储卷类似于 NAS(网络附加存储),支持多个云主机同时挂载并读写。
- 优势:数据持久化保存,不受云主机释放影响;支持多机共享;读写性能优秀。
- 使用场景:存放训练数据集、代码仓库、训练过程中的 Checkpoint 保存、实验日志输出。
- 配置方法:
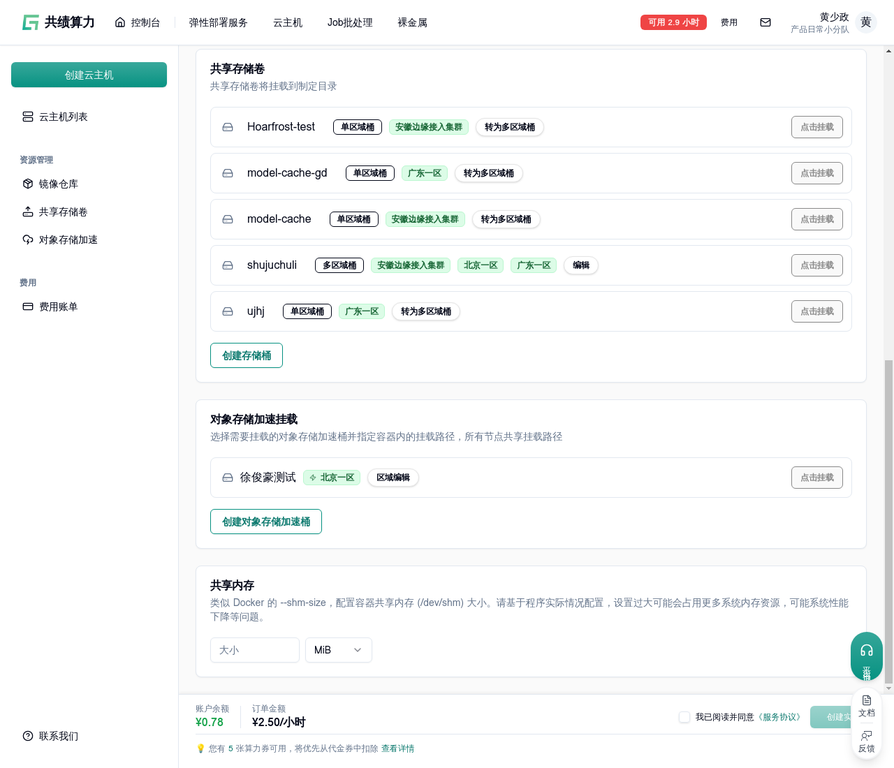
- 在控制台左侧导航栏进入”共享存储卷”页面。
- 点击”创建存储桶”,选择所需区域(如需要跨区使用,可转换为多区域桶)。
- 在创建云主机时,在”共享存储卷”配置区域,选择对应的存储桶并指定挂载目录(如
/workspace/data)。
方案 B:对象存储加速(适合只读的大型模型权重)
对象存储加速功能可以将阿里云 OSS、AWS S3 等对象存储中的数据,通过缓存技术直接挂载到云主机本地。
-
优势:将 S3 缓存到集群本地,大幅提升模型加载速度;无需等待几十 GB 模型缓慢下载;不占用系统盘空间。
-
使用场景:挂载 HuggingFace 模型权重、只读的基础数据集。
-
配置方法:
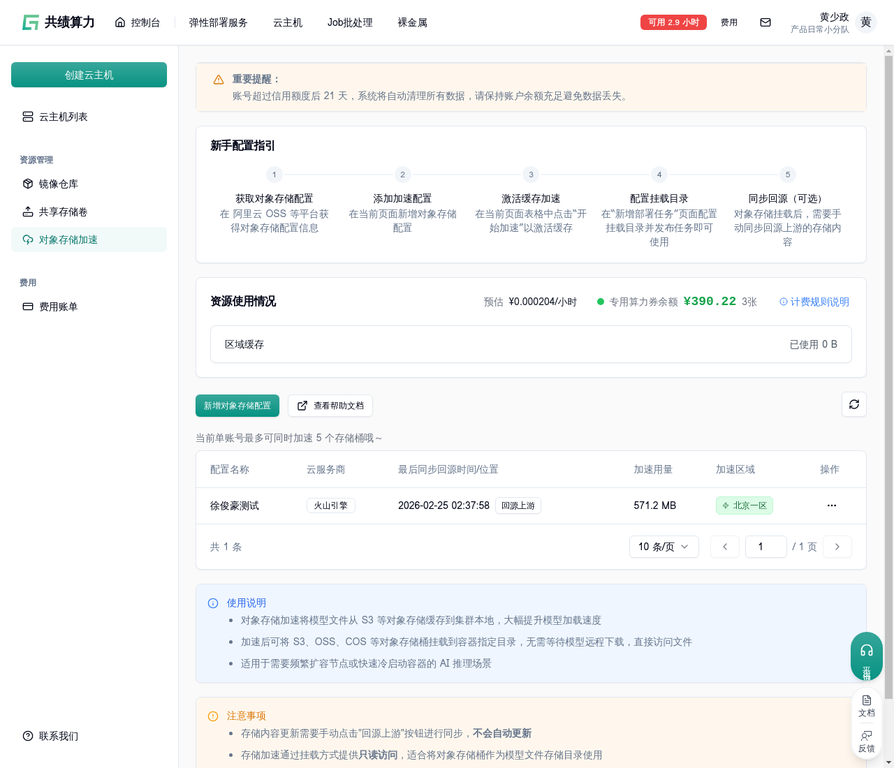
- 在”对象存储加速”页面,添加您在云服务商处的对象存储配置。
- 点击”开始加速”激活缓存。
- 在创建云主机时挂载该加速桶。
-
⚠️ 注意事项:
- 挂载目录为只读访问。
- 存储内容更新需要手动点击”回源上游”按钮同步,不会自动更新。
为什么我的云主机任务一直显示“启动中”?
为什么我的云主机任务一直显示“启动中”?
任务状态持续显示“启动中”,并不意味着任务已卡死,请您放心。
这通常是由于容器环境的初始化流程所致。与虚拟机秒级启动不同,共绩算力云主机会在启动阶段进行以下几项必要工作,根据镜像大小和算力资源池状态,耗时约需 1-3 分钟:
- 高性能算力调度:系统正在为您分配专属的 GPU/NPU 计算节点。
- AI 开发镜像加载:正在拉取并挂载包含完整 Python、CUDA、PyTorch 等依赖的预置开发环境(镜像环境)。
- 持久化存储挂载:正在建立数据卷的远程连接,以保护您的代码不受镜像重启影响。
特别说明:在容器环境下,某些首次写入系统盘的文件会被纳入基础镜像快照,这可能导致下次启动时的环境校验时间略长。只要界面未提示“失败”,请耐心等待进度条走完。
若等待超过 5 分钟 状态仍未更新,再建议您刷新页面或联系技术支持排查节点异常。
为什么云主机节点数不能设置为 0?
为什么云主机节点数不能设置为 0?
共绩算力云主机采用的是容器化持久工作空间,而非函数计算或短生命周期 Pod。一旦将实例数缩减至 0,容器状态会被彻底销毁,虽然挂载的数据卷文件仍在,但以下内容将会丢失,导致下次启动恢复环境耗时极长且可能报错:
- 运行中的内存状态:未保存的 Jupyter 内核变量。
- 系统盘安装的依赖:直接写入
/usr/local或apt install的软件包(因容器镜像机制会被丢弃)。
因此,为了保障“随时随地打开即用”的体验,系统强制保留至少 1 个运行实例作为环境锚点。
总结:标准的高效 AI 开发架构
总结:标准的高效 AI 开发架构
为了获得最佳的体验和性价比,建议您采用以下架构使用共绩算力云主机:
- 系统盘(80GB):仅安装 CUDA、PyTorch、依赖包及核心运行脚本。配置完成后保存为自定义镜像。
- 对象存储加速(只读):挂载至
/models,用于直接读取百 GB 级别的大语言模型权重,实现秒级加载。 - 共享存储卷(读写):挂载至
/data和/output,用于存放微调数据集和保存训练 Checkpoint。
遵循以上架构,您的云主机将实现秒级开机、环境稳定、数据安全的完美体验。